使用指南
提示缓存
重复发送相同的长内容时如何省钱:缓存在哪里显示、怎么计费、各协议怎么写。
很多应用每次请求都会带上一大段相同的开头,比如很长的系统提示词、同一份文档、多轮对话的历史。提示缓存是模型厂商提供的功能:如果这段开头和最近的请求完全一样,厂商可以直接复用之前的处理结果。这样更快,这部分输入的单价通常也更低。
缓存由模型厂商完成,能不能命中、要满足什么条件(比如最短长度、保留多久),都以厂商的规则为准。NoviaHub 负责把你请求里的缓存相关字段交给模型,并按厂商返回的缓存用量计费。
在哪里看缓存用量和价格
Section titled “在哪里看缓存用量和价格”- 价格:在 模型&价格 的模型详情里,价格表有「缓存」一栏,分「读取」和「写入」(部分模型分「写入 (5m)」「写入 (1h)」两档),旁边还有「缓存命中率」。
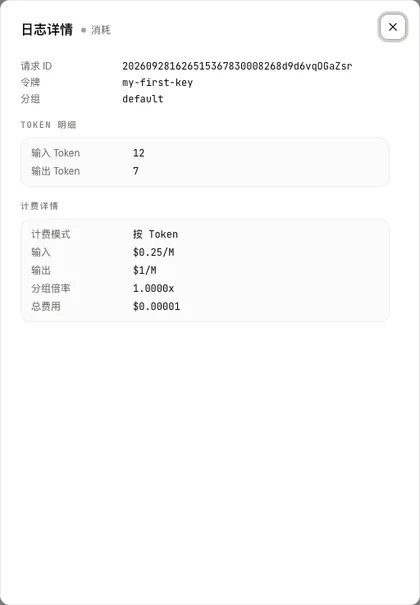
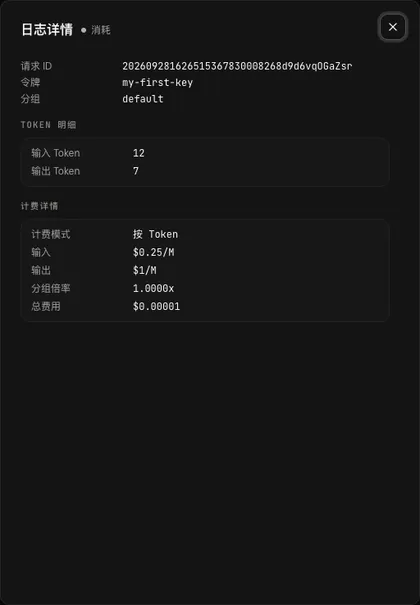
- 每次用量:在使用日志里:
- 「Token」一列会显示缓存读写的数量;
- 打开详情,「Token 明细」里有「缓存读取」「缓存写入」;
- 「计费详情」里是对应的单价。
- 缓存读取:命中缓存的那部分输入 Token,按「缓存读取」单价计费,不再按普通输入单价计。
- 缓存写入:把内容写进缓存时产生的 Token,按「缓存写入」单价计费。部分模型(如 Claude)按缓存保留时间分 5 分钟和 1 小时两档。
- 其余没有命中缓存的输入 Token,按普通输入单价计费。
完整的计费方式见计费说明。
各协议怎么写
Section titled “各协议怎么写”Anthropic Messages(Claude 模型):Claude 需要你在请求里用 cache_control 标出要缓存到哪里。通过 NoviaHub 的 /v1/messages 接口调用时,system 和消息内容块上的 cache_control 都会原样交给模型。
{ "model": "claude-sonnet-5", "max_tokens": 1024, "system": [ {"type": "text", "text": "(很长的系统提示词)", "cache_control": {"type": "ephemeral"}} ], "messages": [{"role": "user", "content": "你好"}]}OpenAI 兼容接口:OpenAI 等厂商的缓存通常是自动的,不需要你额外标注。Chat Completions 和 Responses 请求里都可以带 prompt_cache_key 和 prompt_cache_retention 字段,用同一种协议调用模型时,NoviaHub 会把它们交给模型。这些字段的作用以模型厂商的文档为准。
让缓存更容易命中
Section titled “让缓存更容易命中”- 把不变的内容放在最前面(系统提示词、文档、工具定义),会变的内容(用户这次的问题)放在最后。缓存匹配的是开头完全相同的部分,开头只要有一个字不同,后面就无法复用。
- 连续请求之间不要间隔太久,缓存过期后就需要重新写入。